Pegas en la terminal un prompt larguísimo para que el modelo construya un sitio web completo de frontend: TypeScript, datos de prueba, modo oscuro, accesibilidad, pruebas unitarias y, además, que él mismo ejecute comandos para revisar su trabajo. Pulsas Enter. El uso de GPU de las cuatro máquinas salta al 100 % al mismo tiempo, el equipo se va calentando poco a poco y, sin embargo, no aparece una sola palabra en pantalla durante un buen rato.
No es una avería. Es el aspecto más real de ejecutar un modelo gigante en local: la máquina está muy ocupada y a ti solo te toca esperar.
Esta escena viene de una prueba en video del YouTuber Alex Ziskind. Entregó la misma tarea de desarrollo frontend a dos candidatos a la vez: un clúster de cuatro Mac Studio armado por él mismo, que ejecuta el modelo abierto Kimi K3, y Supercomputer, de la plataforma en la nube Abacus AI. Ambos terminaron el trabajo. La diferencia está en el tiempo, en el dinero y en lo que estás dispuesto a confiar a terceros.
Es la segunda ronda de "local vs nube"
Primero, el contexto. El autor ya había hecho un enfrentamiento anterior en el que el lado local era una sola Mac Studio de 512 GB, y en los comentarios le dijeron que eso no contaba como una configuración local de verdad. Por eso esta vez llevó las especificaciones al límite.
El modelo es Kimi K3, que en el video se describe con 2,8 billones de parámetros y un archivo original de unos 1,56 TB, demasiado grande para una sola Mac Studio. El hardware son cuatro Mac Studio con 512 GB de memoria unificada cada una, 2 TB en total, conectadas entre sí de dos en dos con Thunderbolt 5 (seis cables) y con RDMA y MLX distributed para repartir el modelo entre las cuatro. Lo que se ejecutó realmente fue una versión cuantizada y reducida, con unos 817 GB de pesos, pero sin podar: los 896 expertos permanecen activos.
¿Por qué cuatro máquinas? Porque el paralelismo tensorial divide las dimensiones del modelo en partes iguales, así que el número de equipos solo puede ser 1, 2, 4 u 8. Con tres no funciona.
Hay un detalle fácil de pasar por alto. 817 GB parecen caber en dos máquinas, pero el autor señala que dio un contexto muy largo y que eso exige bastante más espacio que los pesos por sí solos, de modo que dos no bastaban. En las capturas del video, durante la ejecución, las cuatro máquinas mostraban unos 208, casi 200, 177 y 215 GB en uso.
Del lado de la nube: no es una ventana de chat, es un ordenador que nunca se apaga
El punto fuerte de Abacus Supercomputer es que, en realidad, se trata de una máquina virtual permanente en la nube y no solo de un cuadro de conversación. Según se presenta en el video, integra tareas programadas, bases de datos, almacenamiento, GitHub y SSH, y permite cambiar entre más de cien modelos desde la misma entrada, de GPT, Claude y Grok a DeepSeek, GLM y Kimi K3, con RouteLLM eligiendo el modelo según la situación.
En este lado se usaron Opus 5 (high) y GPT-5.6 Sol. Conviene subrayarlo: los dos lados no usan el mismo modelo, así que lo que se compara es una solución local completa frente a una solución en la nube completa, no un duelo puro entre modelos.
También hay que dejar clara una divulgación: el propio video indica que es un contenido patrocinado por Abacus AI, y el autor se advierte a sí mismo en pantalla de que no debe emocionarse demasiado porque es un video patrocinado. Al leer una comparación así, lo más exacto es tratarla como un caso con postura propia, pero con un proceso de demostración que se puede revisar.
El mismo prompt, dos tipos de espera
Los dos lados recibieron el mismo prompt: construir el frontend de un "intercambio de cómputo de silicio", con TypeScript, datos de prueba, modo oscuro, microinteracciones, accesibilidad y pruebas unitarias, y con la exigencia de que el modelo verificara su propio trabajo. El autor añade que era la primera vez que ejecutaba ese prompt.
Según la demostración del autor, la nube avanzó rápido: generó HTML enseguida, montó un proyecto Next.js dentro de la máquina virtual y, al arrancarlo allí, ya se veía el resultado. Su reacción fue que el resultado quedó muy bien, con un panel de control, filtros en tiempo real con animación, exploración de inventario, un panel de comparación y función de reservas, todo con un solo prompt y sin conectar ningún backend.
El lado local tuvo otro ritmo. Las cifras que midió el autor fueron unos 238 tokens por segundo en el procesamiento del prompt (prefill) y unos 14,7 tokens por segundo en la generación. Explica que la fortaleza de los Mac es el gran ancho de banda de memoria, que hace muy fluida la generación una vez procesado el prompt, pero que en la fase de prefill con prompts largos quedan por detrás de las GPU de Nvidia. Juntas, esas dos cifras significan que cuanto más largo es el prompt, más paciencia necesitas.
El giro: no es que no pueda hacerlo, es que tienes que levantarte de la silla
Al principio el autor creyó que el lado local se había roto, porque pasó mucho tiempo sin ver ninguna salida. Probó con un simple "hi" y el modelo respondió. Luego pidió una página sencilla con un cuadro de texto y un botón, y en unos 3 minutos y 147 líneas estaba lista; la describió como bastante bonita.
Entonces detuvo la grabación, volvió a pasar el prompt completo y se fue a tomar un café. Unas 4 horas después, al regresar, había una aplicación completa: filtros, comparación, gráficos, programación y modos claro y oscuro, todo presente.
Así que la respuesta a "¿se puede hacer en local?" es que sí. Pero la conclusión del autor es que la misma aplicación tardó unos 15 minutos en la nube y unas 4 horas en local, y esa diferencia es la verdadera etiqueta de precio. Ten en cuenta que las 4 horas son una cifra aproximada de una sola prueba, el momento en que él volvió a mirar, no un cronometraje exacto.
Cómo se hacen las cuentas: compra única frente a mensualidad
Las comparaciones de costos del video merecen desglosarse. Sobre el hardware, cada Mac Studio cuesta unos 16.000 dólares y el autor supone (sus palabras son "creo") que ya no se vende, por lo que el precio solo sería mayor. Una vez comprada, es tuya y puedes usarla como quieras. Sobre la nube, Abacus empieza en 10 dólares al mes, con el primer mes a 7 dólares, y según el autor, contando solo la mensualidad, pasaría muchísimo tiempo antes de alcanzar el costo del hardware. Sobre el enrutamiento, la solución en la nube admite un enrutador personalizado que manda las tareas simples a modelos baratos y reserva los caros para las difíciles.
Todas estas cifras son afirmaciones orales del video y no las hemos verificado de forma independiente; para precios reales, consulta los anuncios oficiales. Más importante es lo que la cuenta deja fuera: el costo de esperar 4 horas, la electricidad y el tiempo de mantenimiento. Lo que ahorras es la suscripción mensual, y a cambio recibes tiempo y carga de administración. Esa cuenta no tiene una respuesta estándar.
Para un equipo que usa APIs con frecuencia, es la misma clase de decisión que enfrentas al calcular tu factura de tokens: el modelo caro se encarga de lo difícil y el barato de lo rutinario.
¿Cuándo conviene quedarse en local?
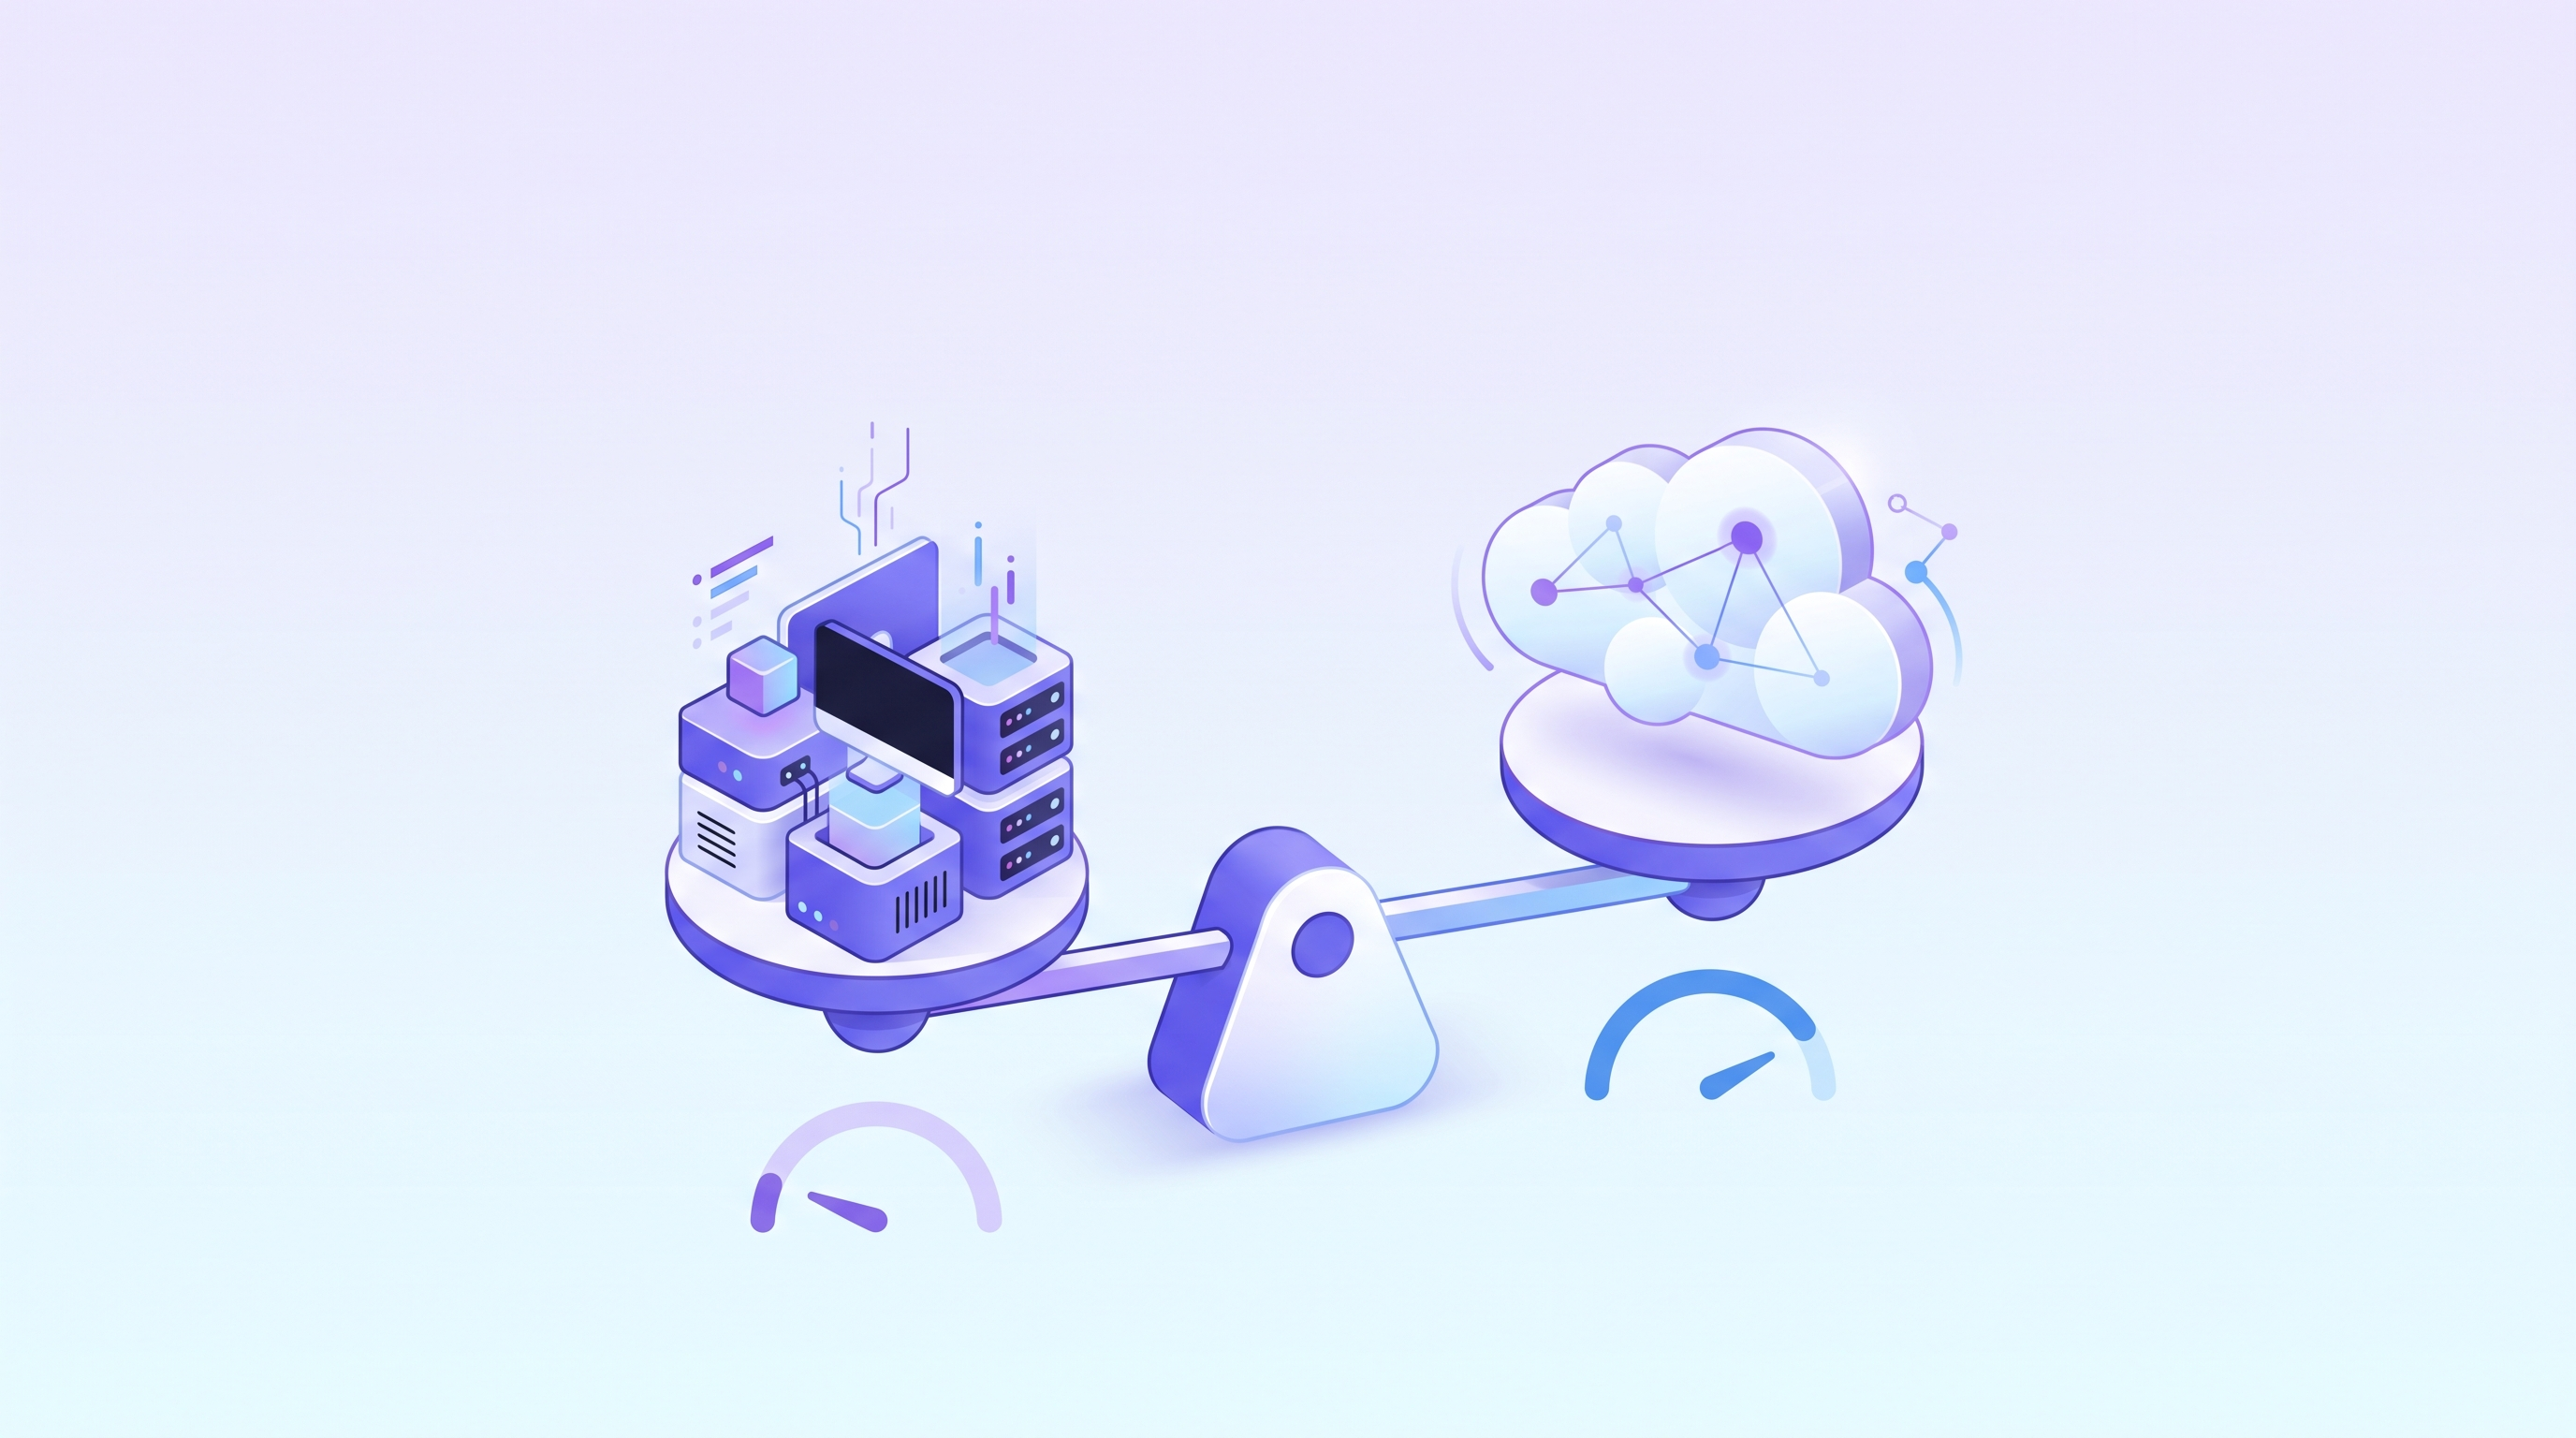
La conclusión del autor es bastante contenida, y él mismo dice que no es lo que querría oír el patrocinador: si quieres alta calidad, velocidad y un alojamiento gestionado todo en uno, gana la nube; pero si tus datos no pueden salir de la oficina, o simplemente te gusta ejecutarlo todo tú mismo, el clúster sigue teniendo sentido. Considera que ambos mercados existen y que no es una elección excluyente.
Su propia forma de trabajar consiste en usar agentes para crear herramientas pequeñas de un solo uso, un tipo de necesidad que exige rapidez y poder ejecutarse al instante, y para eso la nube le resulta ideal. Esto también recuerda algo al lector: primero aclara cómo es tu tarea y después decide dónde poner los recursos.
Preguntas frecuentes (FAQ)
P1: ¿La IA local y la IA en la nube del video se compararon con el mismo modelo? No. El lado local ejecutó Kimi K3, mientras que el lado de la nube usó Opus 5 (high) y GPT-5.6 Sol. Lo que se compara es la velocidad de finalización y el resultado de cada solución completa, no una clasificación de capacidad entre modelos individuales.
P2: ¿Ejecutar modelos grandes en local siempre es más lento? Depende del hardware y de la tarea. Las condiciones de este video eran un modelo enorme y un prompt larguísimo, con una velocidad de prefill medida de unos 238 tokens por segundo, por eso resultó especialmente lento. El autor también explica que, tras procesar el prompt, la fase de generación en los Mac es relativamente fluida. Con un modelo pequeño o un prompt corto, la conclusión podría ser muy distinta.
P3: ¿Se pueden tomar 4 horas frente a 15 minutos como una diferencia de velocidad general? No lo recomendamos. Es una prueba única, el propio autor dice que fue la primera vez que ejecutó ese prompt, y las 4 horas son el tiempo aproximado que vio al volver tras alejarse. Tómalo como una observación de este escenario, no como una prueba de rendimiento.
P4: ¿Por qué cuatro Mac Studio y no tres? El autor explica que el paralelismo tensorial reparte las dimensiones del modelo entre los nodos y estas deben poder dividirse en partes iguales, por lo que el número de equipos solo puede ser 1, 2, 4 u 8.
Declaración de fuentes
Este artículo es una reescritura y síntesis, no una traducción literal. El contenido se reorganiza a partir de los subtítulos del siguiente video de YouTube; todas las especificaciones de hardware, velocidades, tiempos y precios son afirmaciones orales del autor del video y no las hemos vuelto a medir de forma independiente. Los subtítulos son automáticos y algunos nombres de modelos podrían tener errores de escritura. El video se declara como contenido patrocinado por Abacus AI, y la descripción de las capacidades del producto en la nube corresponde a lo que afirman el patrocinador y el autor. Título del video: I Gave Local AI and the Cloud the Exact Same Job. Canal: Alex Ziskind. Enlace: https://www.youtube.com/watch?v=ujs0_cpAnaw. Fecha de publicación: 2026-08-31.
Para seguir leyendo
En nuestro sitio hemos publicado artículos relacionados: una prueba de Opus 4.8 frente a Fable 5 construyendo la misma aplicación con las mismas instrucciones, para ver cuánto difieren en capacidad y en costo de tokens; una comparación de GPT-6 Astra frente a Fable 5.1 con 15 tareas de trabajo reales; una explicación de por qué los AI Token resultan tan caros, desglosando el funcionamiento autorregresivo detrás del gasto de los agentes de programación; y cinco técnicas probadas para reducir el costo en tokens al programar con IA, usando Claude Fable 5 como ejemplo.
Antes de volver a pulsar Enter
Vuelve a la imagen del principio. Ahora sabes que cuatro máquinas a plena carga sin ninguna salida no significan que algo esté roto, ni que el modelo sea más torpe, sino que elegiste cambiar tiempo por control.
Lo que de verdad conviene preguntarse antes de pulsar Enter es si este trabajo debe entregarse en pocos minutos o puede quedarse corriendo toda una tarde, si tus datos pueden salir de tu entorno y si los pasos difíciles y los sencillos merecen tratarse con el mismo modelo.
Si todavía dudas entre local y nube para ese trabajo, elige una tarea real tuya, ejecútala una vez con la misma clave de AI Token King, anota los tokens que realmente se consumen y luego haz tu cuenta. Puedes probar AI Token King gratis en aitokenking.com.tw/home.